> For the complete documentation index, see [llms.txt](https://sorodriguezz.gitbook.io/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://sorodriguezz.gitbook.io/docs/system-design/sistemas-distribuidos-y-microservicios/explicacion-del-protocolo-gossip.md).
# Explicación del protocolo Gossip
#### ¿Qué es el protocolo Gossip?
Los problemas típicos en un sistema distribuido son los siguientes \[1], \[11]:
* Mantener el estado del sistema (vidad de los nodos)
* comunicación entre nodos
Las posibles soluciones a estos problemas son las siguientes \[1]:
* servicio centralizado de gestión estatal
* servicio de gestión estatal entre pares
#### Servicio de Gestión Estatal Centralizada
Un servicio de gestión de estado centralizado como Apache Zookeeper se puede configurar como el [descubrimiento de servicio ](https://systemdesign.one/what-is-service-discovery/?ref=highscalability.com)para realizar un seguimiento del estado de cada nodo del sistema. Aunque este enfoque proporciona una fuerte garantía de consistencia, los principales inconvenientes son que el servicio de gestión estatal se convierte en un único punto de fallo y se ejecuta en problemas de escalabilidad para un gran sistema distribuido \[1], \[11].
#### Servicio de gestión estatal entre pares
El enfoque de gestión estatal entre pares se inclina hacia una alta disponibilidad y una eventual consistencia. Los algoritmos del protocolo Gossip se pueden utilizar para implementar servicios de gestión estatal entre pares con alta escalabilidad y una mayor resiliencia \[1].
El protocolo Gossip también se conoce como **protocolo** de **epidemias** porque la transmisión de los mensajes es similar a la forma en que se propagan[ las epidemias](https://en.wikipedia.org/wiki/Epidemic?ref=highscalability.com). El concepto de comunicación en el protocolo Gossip es análogo a la difusión de rumores entre el personal de la oficina o la difusión de información en un sitio web de redes sociales \[4], \[8].
### Protocolos de transmisión
Las técnicas populares de transmisión de mensajes en un sistema distribuido son las siguientes:
* transmisión punto a punto
* transmisión confiable ansiosa
* protocolo Gossip
#### Transmisión Punto A Punto
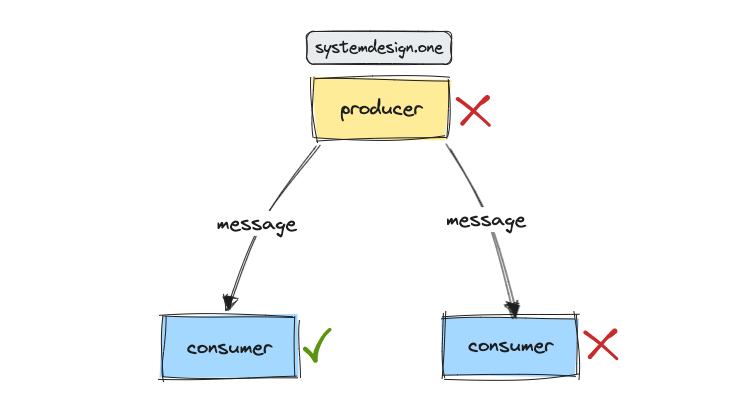
El productor envía un mensaje directamente a los consumidores en una transmisión punto a punto. El mecanismo de reintento en el productor y el mecanismo de deduplicación en los consumidores hacen que la transmisión punto a punto sea fiable. Los mensajes se perderán cuando el productor y el consumidor fallen simultáneamente \[3].
**Transmisión confiable y ansiosa**
Cada nodo retransmite los mensajes a todos los demás nodos a través de enlaces de red fiables. Este enfoque proporciona una mejor tolerancia a fallas porque los mensajes no se pierden cuando tanto el productor como el consumidor fallan simultáneamente. El mensaje será retransmitido por los nodos restantes. Las advertencias de la transmisión confiable ansiosa son las siguientes \[3], \[8]:
* uso significativo del ancho de banda de la red debido a que los mensajes O(n²) se transmiten para *n* número de nodos
* El nodo de envío puede convertirse en un cuello de botella debido a la transmisión lineal O(n)
* cada nodo almacena la lista de todos los nodos del sistema, lo que aumenta los costos de almacenamiento
#### Protocolo Gossip
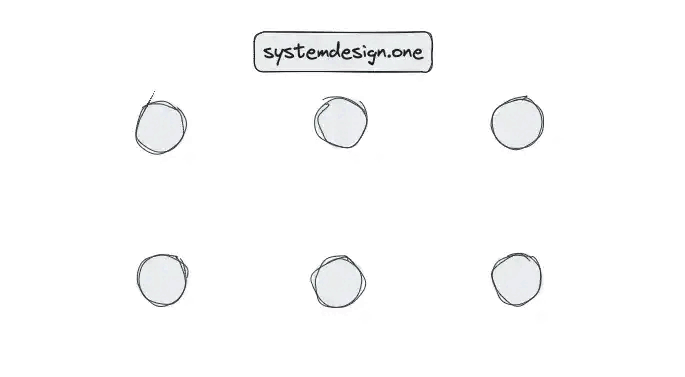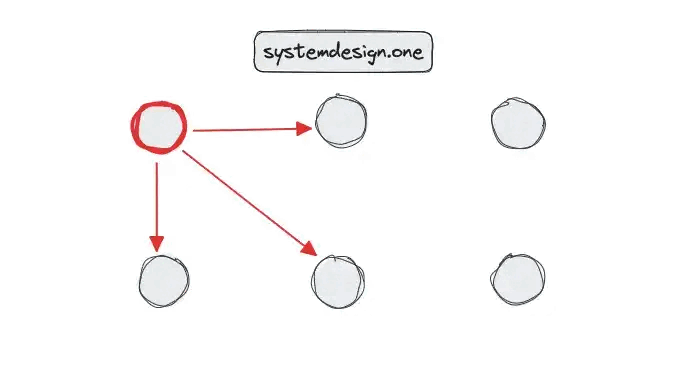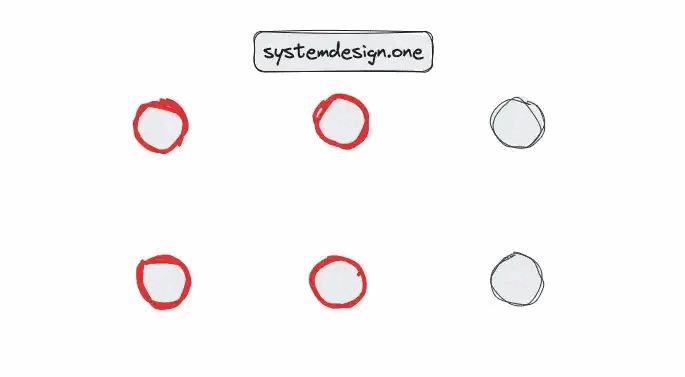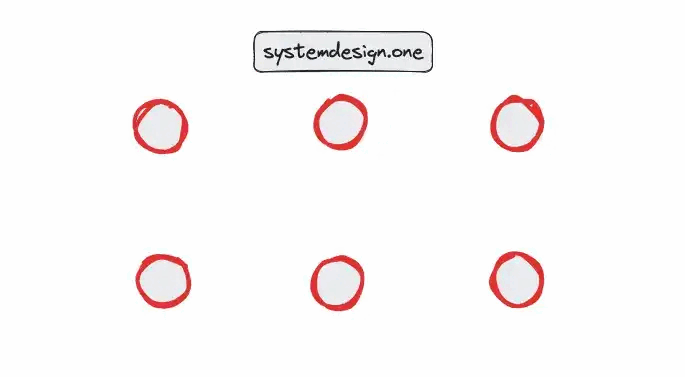
El protocolo Gossip es una técnica descentralizada de comunicación entre pares para transmitir mensajes en un enorme sistema distribuido \[1], \[8]. El concepto clave del protocolo Gossip es que cada nodo envía periódicamente un mensaje a un subconjunto de otros nodos aleatorios \[8], \[2]. Todo el sistema recibirá el mensaje en particular eventualmente con una alta probabilidad \[11], \[3]. En términos sencillos, el protocolo Gossip es una técnica para que los nodos construyan un mapa global a través de interacciones locales limitadas \[1].
El protocolo Gossip se basa en un algoritmo robusto, escalable y, en ten, de, consistencia. El protocolo Gossip se utiliza normalmente para mantener la lista de miembros de nodos, lograr consenso y detección de fallas en un sistema distribuido \[2]. Además, la información adicional, como los datos a nivel de aplicación, se puede aprovechar en los mensajes Gossip \[1].
El protocolo Gossip es confiable porque un fallo de nodo se puede superar mediante la retransmisión de un mensaje por otro nodo. La transmisión de primero en entrar, primero en salir (**FIFO**), la transmisión de causalidad y la transmisión de orden total se pueden implementar con el protocolo Gossip \[3].
Los parámetros del protocolo Gossip como el ciclo y el fanout se pueden ajustar para mejorar las garantías probabilísticas del protocolo Gossip. Las siguientes herramientas ofrecen una simulación y visualización de alta gama del protocolo Gossip \[8], \[5]:
* [simulador de convergencia de siervo](https://www.serf.io/docs/internals/simulator.html?ref=highscalability.com)
* [simulador ](https://flopezluis.github.io/gossip-simulator/?ref=highscalability.com)Gossip
Las siguientes características del protocolo Gossip lo confieren en una opción óptima como protocolo de comunicación en un sistema distribuido a gran escala \[12]:
* limita el número de mensajes transmitidos por cada nodo
* limita el consumo de ancho de banda para evitar la degradación del rendimiento de la aplicación
* tolera fallas de red y nodos
El protocolo Gossip se puede utilizar para mantener los nodos consistentes solo cuando las operaciones ejecutadas son conmutativas y la serialización no es necesaria. La **lápida** es una entrada especial para invalidar las entradas de datos que tienen una clave coincidente sin la eliminación real de los datos. El protocolo Gossip elimina los datos de un nodo usando una lápida.
### Tipos de protocolo Gossip
El tiempo requerido por el protocolo Gossip para propagar un mensaje a través del sistema y el tráfico de red generado al propagar un mensaje deben tenerse en cuenta al elegir el tipo de protocolo Gossip para un caso de uso particular \[10]. El protocolo Gossip se puede clasificar ampliamente en los siguientes tipos \[8], \[10]:
* modelo anti-entropía
* modelo de rumor
* modelo de agregación
#### **Protocolo** Gossip **antientropía**
El algoritmo antientropía se introdujo para reducir la entropía entre réplicas de un servicio con estado como la base de datos. Se comparan los datos replicados y se parchea la diferencia entre las réplicas \[10]. El nodo con el mensaje más reciente lo comparte con otros nodos en cada ronda Gossip \[8].
El modelo antientropía generalmente transfiere todo el conjunto de datos, lo que resulta en un uso innecesario del ancho de banda. Las técnicas como la suma de comprobación, la lista de actualizaciones recientes y el [árbol Merkle ](https://en.wikipedia.org/wiki/Merkle_tree?ref=highscalability.com)se pueden utilizar para identificar las diferencias entre los nodos para evitar la transmisión de todo el conjunto de datos y reducir el uso del ancho de banda de la red. El protocolo Gossip anti-entropía enviará un número ilimitado de mensajes sin terminación \[8].
#### **Protocolo** Gossip **de rumores**
El protocolo de difusión de rumores también se conoce como **protocolo** de **difusión**. El ciclo de rumores ocurre con relativa más frecuencia que los ciclos antientropía e inunda la red con la carga del peor de los casos \[10]. El modelo de rumoreo utiliza menos recursos, como el ancho de banda de la red, ya que solo las últimas actualizaciones se transfieren a través de los nodos \[8].
Un mensaje se marcará como eliminado después de unas pocas rondas de comunicación para limitar el número de mensajes. Por lo general, hay una alta probabilidad de que un mensaje llegue a todos los nodos \[8].
#### **Protocolo** Gossip **de agregación**
El protocolo Gossip de agregación calcula un agregado de todo el sistema muestreando información a través de cada nodo y combinando los valores para generar un valor en todo el sistema \[10].
### Más recursos de aprendizaje de diseño de sistemas
[**Suscríbete al boletín de diseño del sistema** ](https://systemdesignone.substack.com/?ref=highscalability.com)y no te pierdas nunca más una nueva publicación de blog. También recibirá la **guía definitiva** para abordar **las entrevistas de diseño de sistemas** al [suscribirse al boletín](https://systemdesignone.substack.com/?ref=highscalability.com).
### Estrategias para difundir un mensaje a través del protocolo Gossip
El protocolo Gossip es un marco óptimo para construir un servicio altamente disponible. La estrategia para difundir un mensaje a través del protocolo Gossip debe elegirse en función de los requisitos del servicio y las condiciones de la red disponibles. Hay compensaciones en términos de ancho de banda, latencia y fiabilidad con cada estrategia para difundir un mensaje. Las estrategias para difundir un mensaje se aplican tanto a los modelos antientropía como a los que propagan rumores. Las diferentes estrategias para difundir un mensaje con el protocolo Gossip son las siguientes \[8], \[5], \[2]:
* modelo de empuje
* modelo de tracción
* modelo push-pull
**Modelo de empuje**
El modelo push es eficiente cuando solo hay unos pocos mensajes de actualización debido a la sobrecarga de tráfico. El nodo con el último mensaje envía el mensaje a un subconjunto aleatorio de otros nodos en el modelo push \[8].
**Modelo de tracción**
Cada nodo encuestará activamente un subconjunto aleatorio de nodos para cualquier mensaje de actualización en el modelo de extracción. Este enfoque es eficiente cuando hay muchos mensajes de actualización porque es muy probable encontrar un nodo con el último mensaje de actualización \[8].
**Modelo Push-Pull**
El modelo push-pull es óptimo para difundir mensajes de actualización de forma rápida y fiable \[2]. El nodo puede enviar un nuevo mensaje de actualización y el nodo también puede sondear nuevos mensajes de actualización. El enfoque de empuje es eficiente durante la fase inicial cuando solo hay muy pocos nodos con mensajes de actualización. El enfoque de extracción es eficiente durante la fase final cuando hay numerosos nodos con muchos mensajes de actualización \[8].
### Rendimiento del Protocolo Gossip
El número de nodos que recibirán el mensaje de un nodo en particular se conoce como thefanout. El recuento de rondas Gossip necesarios para difundir un mensaje a través de todo el grupo se conoce como el **ciclo** \[8], \[5].
> Ciclos necesarios para difundir un mensaje a través del clúster = O(log n) a la base de fanout, donde n = número total de nodos
Por ejemplo, se necesitan aproximadamente 15 rondas Gossip para propagar un mensaje a través de 25.000 nodos. El intervalo Gossip se puede establecer en un valor tan bajo como 10 ms para propagar un mensaje a través de un gran centro de datos en aproximadamente 3 segundos. La propagación de un mensaje en el protocolo Gossip debería envejecer automáticamente para reducir la carga innecesaria \[4]. El rendimiento de la implementación de un protocolo Gossip se puede medir con las siguientes métricas \[8]:
* Residuo: el número de nodos restantes que no han recibido los mensajes debe ser mínimo
* tráfico: el número promedio de mensajes enviados entre nodos debe ser mínimo
* convergencia: cada nodo debe recibir el mensaje lo más rápido posible
* promedio de tiempo: el tiempo promedio tomado para enviar el mensaje a cada nodo debe ser bajo
* hora de última: el tiempo que tarda el último nodo en recibir el mensaje debe ser bajo
Un estudio de caso mostró que un sistema con 128 nodos consumía menos del 2 por ciento de la CPU y menos de 60 KBps de ancho de banda para ejecutar el protocolo Gossip \[11].
#### Propiedades del protocolo Gossip
No hay una forma formal de definir el protocolo Gossip. En general, se espera que el protocolo Gossip satisfaga las siguientes propiedades \[8]:
* La selección del nodo debe ser aleatoria para realizar un fanout
* solo la información local está disponible para cada nodo y los nodos son ajenos al estado del clúster
* La comunicación entre nodos implica interacciones periódicas, por pares, entre procesos
* Capacidad de transmisión de tamaño limitado por ronda Gossip
* cada nodo despliega el mismo protocolo Gossip
* Se supone que las rutas de red no fiables entre los nodos
* la frecuencia de interacción del nodo es baja
* Las interacciones de nodos resultan en un intercambio de estado
#### Algoritmo Gossip
La visión general de alto nivel del algoritmo Gossip es la siguiente \[6], \[1]:
1. cada nodo mantiene una lista del subconjunto de nodos y sus metadatos
2. Gossip a un punto final de un nodo de par vivo aleatorio periódicamente
3. cada nodo inspecciona el mensaje Gossip recibido para fusionar el número de versión más alto con el conjunto de datos local
El contador de latidos de un nodo se incrementa cada vez que un nodo en particular participa en el intercambio Gossip. El nodo se etiqueta como saludable cuando el contador de latidos sigue aumentando. Por otro lado, el nodo se considera insalubre cuando el contador de latidos del corazón no ha cambiado durante un período prolongado debido a una partición de red o un fallo del nodo \[1]. Los siguientes son los diferentes criterios para la selección de nodos pares en el protocolo Gossip \[12]:
* utilizar la biblioteca ofrecida por lenguajes de programación como java.util.random
* interactuar con el nodo menos contactado
* Hacer cumplir la interacción [consciente de la topología de la red](https://dl.acm.org/doi/10.1109/TPDS.2006.85?ref=highscalability.com)
#### Implementación del protocolo Gossip
El protocolo Gossip transporta mensajes a través del Protocolo de Datagrama de Usuario (**UDP**) o Protocolo de Control de Transmisión (**TCP**) con una salida e intervalo configurables pero fijas \[12]. El **servicio de muestreo de pares** es utilizado por el protocolo Gossip para identificar los nodos de pares para el intercambio de mensajes Gossip. El servicio de muestreo de pares utiliza un algoritmo aleatorio para la selección de un nodo de pares. La interfaz de programación de aplicaciones (**API**) del servicio de muestreo de pares debe proporcionar los siguientes puntos finales \[8]:
* /gossip/init: devuelve la lista de nodos conocidos a un nodo en particular en el inicio
* /gossip/get-peer: devuelve la dirección (dirección IP y número de puerto) de un nodo de par independiente
El flujo de trabajo de la ejecución del servicio de muestreo por pares es el siguiente \[8]:
1. inicializar cada nodo con una vista parcial del sistema (una lista con el subconjunto de nodos)
2. fusiona la vista del nodo con la vista del nodo par en el intercambio Gossip
En otras formas, cada nodo mantiene una pequeña tabla de membresía local con una vista parcial del sistema y actualiza periódicamente la tabla a través de mensajes Gossip. El protocolo Gossip puede aprovechar la distribución probabilística para seleccionar un nodo par para reducir la transmisión de mensajes duplicados al mismo nodo \[4].
El estado de la aplicación se puede transferir como pares clave-valor a través del protocolo Gossip. El valor más reciente debe transferirse cuando un nodo realiza varios cambios en la misma clave. La API proporcionada por el protocolo Gossip para orquestar el intercambio de estado de la aplicación es la siguiente \[6]:
* /gossip/en-unirse
* /gossip/en-vivo
* /gossip/en-muerto
* /gossip/en-cambio
Los **nodos semilla** son nodos totalmente funcionales que se basan en la configuración estática. Cada nodo del sistema debe ser consciente de los nodos de semilla. El sistema Gossip interactúa con los nodos de semilla para evitar divisiones lógicas \[4], \[12]. El siguiente es el flujo de trabajo de alto nivel cuando un nodo recibe un mensaje Gossip con los metadatos del nodo de un nodo par \[12]:
1. compara el mensaje Gossip entrante para identificar los valores que faltan en el conjunto de datos del nodo local
2. comparar el mensaje Gossip entrante para identificar los valores que faltan en el conjunto de datos del nodo par
3. El valor de versión más alto se elige cuando el nodo ya contiene los valores presentes en el mensaje Gossip entrante
4. añadir los valores que faltan en el conjunto de datos del nodo local
5. devuelve los valores que faltan en el conjunto de datos del nodo par en la respuesta
6. actualizar el conjunto de datos del nodo de pares con la respuesta recibida
Es típico transferir todos los metadatos del nodo a través del protocolo Gossip en el inicio de un nodo. Cada nodo puede mantener un número de versión en memoria para enviar solo actualizaciones incrementales de los metadatos del nodo a través del protocolo Gossip.
El [reloj de generación ](https://martinfowler.com/articles/patterns-of-distributed-systems/generation.html?ref=highscalability.com)es un número monótonamente creciente que indica la generación del servidor. El reloj de generación se incrementa cada vez que el nodo se reinicia. El número de versión garantiza el pedido y el control de versiones del estado de la aplicación. El número de versión solo se puede incrementar \[6]. El reloj de generación se puede usar junto con el número de versión para detectar correctamente los cambios de metadatos del nodo en los reinicios de los nodos \[12].
El **temporizador** Gossip es un componente del protocolo Gossip que garantizará que cada nodo contenga eventualmente los metadatos cruciales sobre los nodos pares, incluidos los nodos que están detrás de una partición de red. Cada nodo incluye un latido del corazón asociado a él. El estado de latido consiste en la generación y el número de versión. El estado de la aplicación consiste en pares clave-valor que representan el estado del nodo y un número de versión \[6].
Un nodo que inicia un intercambio Gossip envía un mensaje **de sincronización de compendios** Gossip que consiste en una lista de **regesúmenes** Gossip. El resumen Gossip consiste en una dirección de punto final, un número de generación y un número de versión. El mensaje de reconocimiento del resumen Gossip consiste en una lista de resumen Gossip y una lista de estado de punto final. El esquema de muestra para el resumen Gossip es el siguiente \[6]:EndPointState: 10.0.1.42\
HeartBeatState: generación: 1259904231, versión: 761\
Estado de la aplicación: "carga media": 2.4, generación: 1659909691, versión: 42\
ApplicationState: "bootstrapping": pxLpassF9XD8Kymj, generación: 1259909615, versión: 90
#### Casos de uso del protocolo Gossip
El protocolo Gossip se utiliza en una multitud de aplicaciones donde se favorece la eventual consistencia. Las aplicaciones populares del protocolo Gossip son las siguientes \[8], \[5], \[4], \[7], \[12]:
* replicación de base de datos
* Difusión de información
* Mantener la pertenencia al clúster
* detección de fallos
* generar agregaciones (calcular promedio, máximo, suma)
* generar [redes de superposición](https://en.wikipedia.org/wiki/Overlay_network?ref=highscalability.com)
* elección de líder
El protocolo Gossip se puede utilizar para detectar el fallo de un nodo en un sistema distribuido con alta probabilidad. La detección de fallas de los nodos puede ahorrar recursos como la CPU, el ancho de banda y el espacio de cola. En un sistema distribuido, no es suficiente afirmar un fallo de nodo cuando un solo cliente no puede interactuar con el nodo en particular porque podría haber una ocurrencia de partición de red o fallo de cliente \[1]. Se puede concluir con certeza el fallo de un nodo en particular cuando varios nodos (**clientes**) confirman la vivacidad del nodo en particular a través del protocolo Gossip \[4], \[11].
El protocolo Gossip es significativamente más confiable para el intercambio de datos y el comando y control que a través de las conexiones TCP. El protocolo Gossip permite abstraer la comunicación sobre las propiedades del nodo y del subsistema fuera de la lógica de la aplicación \[11]. Las estadísticas de los nodos, como la carga promedio y la memoria libre, se pueden transmitir en mensajes Gossip para mejorar la toma de decisiones locales sobre fanout.
La información del subsistema, como la profundidad de la cola, los metadatos clave, como los cambios de configuración, e incluso la respuesta a la solicitud, se puede transmitir a través del protocolo Gossip. La agregación de mensajes de actualización de nodos a través del protocolo Gossip permite enviar datos en un solo fragmento en lugar de múltiples mensajes pequeños para reducir los gastos generales de comunicación \[11].
Los mensajes se pueden enrutar a través del clúster de manera óptima identificando la vivacidad de los nodos \[9]. La toma de decisiones a nivel de nodo local sin involucrar un servicio centralizado es la clave para escalar el protocolo Gossip\[4], \[11]. Los mensajes se pueden versionar con un reloj vectorial para ignorar las versiones de mensajes más antiguas por el nodo \[9], \[2]. Los casos de uso en el mundo real del protocolo Gossip son los siguientes \[12], \[8], \[4], \[9], \[11]:
* [Apache Cassandra ](https://cassandra.apache.org/_/index.html?ref=highscalability.com)emplea el protocolo Gossip para mantener la pertenencia al clúster, transferir metadatos de nodo (asignación de tokens), reparar datos no leídos usando árboles Merkle y detección de fallas de nodos
* [El cónsul ](https://www.consul.io/?ref=highscalability.com)utiliza la variante del protocolo Gossip[ de natación ](https://www.cs.cornell.edu/projects/Quicksilver/public_pdfs/SWIM.pdf?ref=highscalability.com)para la membresía de grupos, la elección de líderes y la detección de fallas de los agentes de cónsul
* [CockroachDB ](https://www.cockroachlabs.com/docs/stable/?ref=highscalability.com)opera el protocolo Gossip para propagar los metadatos del nodo
* La cadena de bloques [Hyperledger Fabric ](https://hyperledger-fabric.readthedocs.io/en/release-2.2/gossip.html?ref=highscalability.com)utiliza el protocolo Gossip para la membresía del grupo y la transferencia de metadatos del libro mayor
* [Riak ](https://riak.com/?ref=highscalability.com)utiliza el protocolo Gossip para transmitir el estado del [anillo hash consistente ](https://systemdesign.one/consistent-hashing-explained/?ref=highscalability.com)y los metadatos del nodo alrededor del clúster
* [Amazon S3 ](https://aws.amazon.com/s3/?ref=highscalability.com)utiliza el protocolo Gossip para difundir el estado del servidor por todo el sistema
* [Amazon Dynamo ](https://aws.amazon.com/dynamodb/?ref=highscalability.com)emplea el protocolo Gossip para la detección de fallas y el seguimiento de la membresía del nodo
* El clúster [Redis ](https://redis.io/?ref=highscalability.com)utiliza el protocolo Gossip para propagar los metadatos del nodo
* Bitcoin utiliza el protocolo Gossip para difundir el valor de nonce a través de los nodos de minería
#### Ventajas del protocolo Gossip
Las ventajas del protocolo Gossip son las siguientes \[8], \[2], \[7], \[4], \[5]:
* Escalable
* Tolerante a fallas
* Robusto
* consistencia convergente
* descentralizado
* Simplicidad
* integración e interoperabilidad
* carga limitada
**Escalabilidad**
La escalabilidad es la capacidad del sistema para manejar la carga creciente sin degradación del rendimiento \[2]. El ciclo del protocolo Gossip requiere tiempo logarítmico para lograr la convergencia. Además, cada nodo interactúa solo con un número fijo de nodos y envía solo un número fijo de mensajes independiente del número de nodos en el sistema. Un nodo no espera un reconocimiento para mejorar la latencia \[8], \[4], \[5].
**Tolerancia a fallas**
La tolerancia a fallos es la capacidad del sistema para permanecer funcional en caso de fallos como bloqueos de nodos, particiones de red o pérdida de mensajes. El sistema distribuido que emplea el protocolo Gossip es tolerante a fallas debido a la tolerancia hacia redes poco confiables. La redundancia, el paralelismo y la aleatoriedad ofrecidos por el protocolo Gossip mejoran la tolerancia a fallas del sistema \[2].
Además, la naturaleza simétrica y descentralizada de los nodos fortalece la tolerancia a fallas del protocolo Gossip \[5]. El mismo mensaje generalmente se transmite varias veces a través de varios nodos. En otras formas, hay muchas rutas para el flujo de mensajes entre el origen y el destino. Por lo tanto, un fallo de nodo se supera a través de la transmisión de mensajes a través de otro nodo \[8], \[4].
**Robustez**
La naturaleza simétrica de los nodos que participan en el protocolo Gossip mejora la robustez del sistema \[5], \[4]. Un fallo del nodo no interrumpirá la calidad del sistema. El protocolo Gossip también es robusto contra las particiones de red transitorias. Sin embargo, el protocolo Gossip no es robusto contra un nodo que funciona mal o un mensaje Gossip malicioso a menos que los datos se autoverifiquen \[8], \[7].
Se puede utilizar un sistema de reputación basado en la puntuación para nodos para evitar la corrupción del sistema Gossip por parte de nodos maliciosos. Se deben implementar mecanismos y políticas apropiados como el cifrado, la autenticación y la autorización para hacer cumplir la privacidad y la seguridad del sistema Gossip \[2].
**Consistencia convergente**
La consistencia es la técnica de garantizar la misma vista de estado en todos los nodos del sistema. Los diferentes niveles de consistencia, como la consistencia fuerte, eventual, causal y probabilística, tienen diferentes implicaciones en el rendimiento, la disponibilidad y la corrección del sistema \[2]. El protocolo Gossip converge a un estado consistente en la complejidad del tiempo logarítmico a través de la difusión exponencial de datos \[8], \[5].
**Descentralización**
El protocolo Gossip ofrece un modelo extremadamente descentralizado de descubrimiento de información a través de la comunicación entre pares \[8], \[4], \[5].
**Simplicidad**
La mayoría de las variantes del protocolo Gossip se pueden implementar con muy poco código y baja complejidad \[8], \[5]. La naturaleza simétrica de los nodos hace que sea trivial ejecutar el protocolo Gossip \[7].
**Integración e interoperabilidad**
El protocolo Gossip se puede integrar e interoperar con componentes del sistema distribuidos como la base de datos, la caché y la cola. Se deben definir interfaces comunes, formatos de datos y protocolos para implementar el protocolo Gossip en diferentes componentes del sistema distribuido \[2].
**Carga Limitada**
Los protocolos clásicos del sistema distribuido generalmente generan altas cargas de sobretensión que podrían sobrecargar los componentes individuales del sistema distribuido. El protocolo Gossip producirá solo una carga estrictamente limitada en el peor de los casos en los componentes individuales del sistema distribuido para evitar la interrupción de la calidad del servicio. La selección de nodos pares en el protocolo Gossip se puede ajustar para reducir la carga en los enlaces de red. En la práctica, la carga generada por el protocolo Gossip no solo está limitada, sino también es insignificante en comparación con el ancho de banda disponible \[7].
#### Desventajas del protocolo Gossip
Las desventajas del protocolo Gossip son las siguientes \[1], \[5], \[8], \[2], \[7]:
* eventual consistencia
* Desconocimiento de las particiones de red
* consumo de ancho de banda relativamente alto
* aumento de la latencia
* dificultad en la depuración y pruebas
* El protocolo de membresía no es escalable
* propenso a errores computacionales
**Eventualmente Consistente**
El protocolo Gossip es inherentemente consistente en su final \[1]. El protocolo Gossip es relativamente más lento en comparación con la multidifusión \[5]. También hay una sobrecarga asociada con los mensajes Gossip y el comportamiento Gossip depende de la topología de la red y la heterogeneidad del nodo \[2]. Por lo tanto, habrá algún retraso para reconocer un nuevo nodo o un fallo de nodo por parte del clúster \[12].
**Desconocimiento de la partición de red**
Cuando se produce una partición de red, los nodos de la subpartición seguirán cotilleando entre sí. Por lo tanto, el protocolo Gossip desconoce las particiones de red y podría retrasar significativamente la propagación de mensajes \[1], \[7].
**Ancho de banda**
El protocolo Gossip no es conocido por su eficiencia, ya que el mismo mensaje podría ser retransmitido al mismo nodo varias veces consumiendo ancho de banda innecesario \[5], \[8]. Aunque el uso del ancho de banda por el protocolo Gossip está limitado debido al tamaño del mensaje limitado y al intercambio periódico de mensajes, el fanout efectivo por el intercambio Gossip podría degradarse cuando la cantidad de información que un nodo debe cotillear excede el tamaño del mensaje limitado \[7].
El punto de saturación del protocolo Gossip depende de diferentes parámetros, como la tasa de generación de mensajes, el tamaño del mensaje, el fanout y el tipo de protocolo Gossip \[7], \[8].
**Latencia**
El uso del protocolo Gossip resulta en una mayor latencia porque el nodo debe esperar al siguiente ciclo Gossip (intervalo) para transmitir el mensaje \[5]. El mensaje no desencadena el intercambio Gossip, pero el temporizador de intervalo del protocolo Gossip sí. La complejidad de tiempo requerida para difundir el mensaje a través del sistema es logarítmica \[8], \[4].
**Depuración y pruebas**
La depuración es identificar y corregir los fallos que hacen que el protocolo Gossip se desvíe del comportamiento esperado. La prueba es la capacidad de verificar si el protocolo Gossip cumple con los requisitos funcionales y no funcionales, como el rendimiento, la fiabilidad y la seguridad \[2].
El no determinismo inherente y la naturaleza distribuida del protocolo Gossip hacen que sea difícil depurar y reproducir los fallos \[8], \[5], \[2]. Se pueden usar herramientas y técnicas como simulación, emulación, registro, rastreo, monitoreo y visualización para probar y depurar el sistema Gossip \[2].
**Escalabilidad**
La mayoría de las variantes del protocolo Gossip se basan en un protocolo de membresía no escalable \[5].
**Error de cálculo**
El protocolo Gossip se inclina a errores computacionales debido a nodos maliciosos. Los nodos deben implementar un mecanismo de autocorrección porque la robustez del protocolo Gossip se limita a ciertas clases de fallas \[7]. Sin embargo, el protocolo Gossip es extremadamente confiable, y los resultados con una probabilidad de uno son típicos \[8].
#### Resumen
Cotillear en un sistema distribuido es una bendición, mientras que cotillear en el mundo de la carne es una maldición. El protocolo Gossip se emplea en sistemas distribuidos como Amazon Dynamo y [distribuido counter](https://systemdesign.one/distributed-counter-system-design/?ref=highscalability.com).