> For the complete documentation index, see [llms.txt](https://sorodriguezz.gitbook.io/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://sorodriguezz.gitbook.io/docs/system-design/sistemas-distribuidos-y-microservicios/como-realizar-el-bloqueo-distribuido.md).
# Cómo realizar el bloqueo distribuido
Como parte de la investigación para [mi libro](http://dataintensive.net/) , encontré un algoritmo llamado [Redlock](http://redis.io/topics/distlock) en el sitio web [de Redis](http://redis.io/) . El algoritmo afirma implementar bloqueos distribuidos tolerantes a fallos (o más bien, [arrendamientos](https://pdfs.semanticscholar.org/a25e/ee836dbd2a5ae680f835309a484c9f39ae4e.pdf) \[1]) sobre Redis, y la página solicita comentarios de personas interesadas en sistemas distribuidos. El algoritmo me generó ciertas dudas, así que dediqué un tiempo a reflexionar sobre él y a redactar estas notas.
Dado que ya existen [más de 10 implementaciones independientes de Redlock](http://redis.io/topics/distlock) y desconocemos quiénes utilizan este algoritmo, pensé que valdría la pena compartir mis notas públicamente. No abordaré otros aspectos de Redis, algunos de los cuales ya han sido criticados [en otros lugares](https://aphyr.com/tags/Redis) .
Antes de entrar en detalles sobre Redlock, quiero decir que me gusta mucho Redis y que lo he usado con éxito en producción. Creo que es ideal para situaciones en las que se necesita compartir datos transitorios, aproximados y que cambian rápidamente entre servidores, y donde no hay problema si se pierden ocasionalmente por cualquier motivo. Por ejemplo, un buen caso de uso es mantener contadores de solicitudes por dirección IP (para limitar la velocidad de las solicitudes) y conjuntos de direcciones IP distintas por ID de usuario (para la detección de abusos).
Sin embargo, Redis ha ido ganando terreno gradualmente en áreas de gestión de datos donde se exigen mayor consistencia y durabilidad, lo cual me preocupa, ya que no fue diseñado para ello. Podría decirse que el bloqueo distribuido es una de esas áreas. Analicémoslo con más detalle.
### ¿Para qué utilizas ese candado?
El propósito de un bloqueo es asegurar que, entre varios nodos que podrían intentar realizar la misma tarea, solo uno la ejecute (al menos uno a la vez). Esta tarea podría consistir en escribir datos en un sistema de almacenamiento compartido, realizar cálculos, llamar a una API externa, etc. En términos generales, existen dos razones por las que se podría necesitar un bloqueo en una aplicación distribuida: [por eficiencia o por corrección](https://research.google.com/archive/chubby.html) \[2]. Para distinguir estos casos, podemos preguntarnos qué sucedería si el bloqueo fallara:
* **Eficiencia:** Al bloquear un nodo, se evita realizar el mismo trabajo dos veces innecesariamente (por ejemplo, un cálculo costoso). Si el bloqueo falla y dos nodos terminan realizando la misma tarea, el resultado es un ligero aumento en el costo (se termina pagando 5 centavos más a AWS de lo que se habría pagado de otra manera) o una pequeña molestia (por ejemplo, un usuario recibe la misma notificación por correo electrónico dos veces).
* **Corrección:** El bloqueo impide que los procesos concurrentes interfieran entre sí y alteren el estado del sistema. Si el bloqueo falla y dos nodos trabajan simultáneamente con el mismo dato, el resultado puede ser un archivo corrupto, pérdida de datos, inconsistencia permanente, la administración de una dosis incorrecta de un medicamento a un paciente u otro problema grave.
Ambos son motivos válidos para querer un candado, pero debes tener muy claro con cuál de los dos estás tratando.
Argumentaré que si utilizas bloqueos simplemente por motivos de eficiencia, no es necesario incurrir en el costo y la complejidad de Redlock, que requiere ejecutar 5 servidores Redis y verificar la mayoría para adquirir el bloqueo. Es mejor usar una sola instancia de Redis, quizás con replicación asíncrona a una instancia secundaria en caso de que la principal falle.
Si utilizas una única instancia de Redis, es lógico que se pierdan algunos bloqueos si se produce un corte de energía repentino en tu nodo de Redis o si surge algún otro problema. Pero si solo utilizas los bloqueos para optimizar el rendimiento y los fallos no ocurren con frecuencia, no hay mayor inconveniente. Este escenario en el que Redis destaca es precisamente por su eficiencia. Al menos, si dependes de una única instancia de Redis, resulta evidente para cualquiera que observe el sistema que los bloqueos son aproximados y solo deben utilizarse para fines no críticos.
Por otro lado, el algoritmo Redlock, con sus 5 réplicas y votación por mayoría, parece a primera vista adecuado para situaciones en las que el bloqueo es crucial para *la corrección* . En las siguientes secciones argumentaré que *no* es adecuado para ese propósito. En el resto de este artículo, asumiremos que los bloqueos son cruciales para la corrección y que constituye un error grave que dos nodos diferentes crean simultáneamente que poseen el mismo bloqueo.
### Proteger un recurso con un candado
Dejemos de lado por un momento los detalles de Redlock y analicemos cómo se utiliza un bloqueo distribuido en general (independientemente del algoritmo de bloqueo específico). Es importante recordar que un bloqueo en un sistema distribuido no es como un mutex en una aplicación multihilo. Es un sistema más complejo, debido a que los distintos nodos y la red pueden fallar de forma independiente y de diversas maneras.
Por ejemplo, supongamos que tiene una aplicación en la que un cliente necesita actualizar un archivo en un almacenamiento compartido (por ejemplo, HDFS o S3). Un cliente primero adquiere el bloqueo, luego lee el archivo, realiza algunos cambios, vuelve a escribir el archivo modificado y, finalmente, libera el bloqueo. El bloqueo impide que dos clientes realicen este ciclo de lectura-modificación-escritura simultáneamente, lo que provocaría la pérdida de actualizaciones. El código podría ser similar a este:
```js
// THIS CODE IS BROKEN
function writeData(filename, data) {
var lock = lockService.acquireLock(filename);
if (!lock) {
throw 'Failed to acquire lock';
}
try {
var file = storage.readFile(filename);
var updated = updateContents(file, data);
storage.writeFile(filename, updated);
} finally {
lock.release();
}
}
```
Lamentablemente, incluso con un servicio de bloqueo perfecto, el código anterior es inválido. El siguiente diagrama muestra cómo se pueden producir daños en los datos:
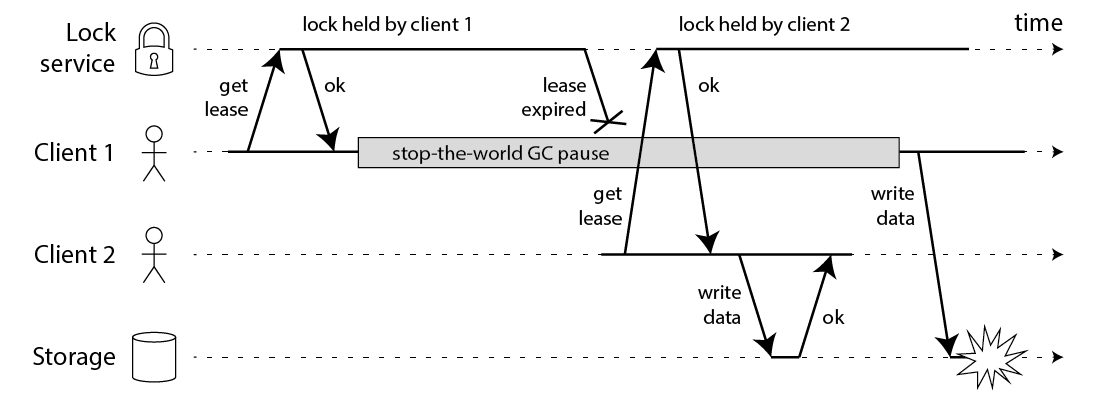 En este ejemplo, el cliente que adquirió el bloqueo se detiene durante un período prolongado mientras lo mantiene, por ejemplo, porque el recolector de basura (GC) se activó. El bloqueo tiene un tiempo de expiración (es decir, es un arrendamiento), lo cual siempre es recomendable (de lo contrario, un cliente que falle podría retener el bloqueo indefinidamente sin liberarlo). Sin embargo, si la pausa del GC dura más que el período de expiración del arrendamiento y el cliente no se da cuenta de que ha expirado, podría realizar algún cambio inseguro.
Este error no es teórico: HBase solía [tener este problema](http://www.slideshare.net/enissoz/hbase-and-hdfs-understanding-filesystem-usage) \[3,4]. Normalmente, las pausas del recolector de basura son bastante cortas, pero se sabe que las pausas del recolector de basura que detienen el sistema a veces duran [varios minutos](https://blog.cloudera.com/blog/2011/02/avoiding-full-gcs-in-hbase-with-memstore-local-allocation-buffers-part-1/) \[5], tiempo suficiente para que expire un arrendamiento. Incluso los llamados recolectores de basura "concurrentes", como el CMS de la JVM HotSpot, no pueden ejecutarse completamente en paralelo con el código de la aplicación; incluso ellos [necesitan detener el sistema](http://mechanical-sympathy.blogspot.co.uk/2013/07/java-garbage-collection-distilled.html) de vez en cuando \[6].
No se puede solucionar este problema insertando una comprobación en la expiración del bloqueo justo antes de escribir en el almacenamiento. Recuerde que el recolector de basura puede pausar un hilo en ejecución en *cualquier momento* , incluso en el punto más inconveniente (entre la última comprobación y la operación de escritura).
Y si te sientes satisfecho porque el entorno de ejecución de tu lenguaje de programación no tiene largas pausas de recolección de basura, hay muchas otras razones por las que tu proceso podría pausarse. Tal vez tu proceso intentó leer una dirección que aún no está cargada en la memoria, por lo que obtiene un fallo de página y se pausa hasta que la página se carga desde el disco. Tal vez tu disco es en realidad EBS, y por lo tanto, leer una variable sin querer se convirtió en una solicitud de red síncrona a través de la red congestionada de Amazon. Tal vez hay muchos otros procesos compitiendo por la CPU, y te encuentras con un [nodo negro en tu árbol de planificación](https://twitter.com/aphyr/status/682077908953792512) . Tal vez alguien envió accidentalmente SIGSTOP al proceso. Sea lo que sea. Tus procesos se pausarán.
Si aún no me crees acerca de las pausas en los procesos, considera que la solicitud de escritura de archivos puede retrasarse en la red antes de llegar al servicio de almacenamiento. Las redes de paquetes como Ethernet e IP pueden retrasar los paquetes *arbitrariamente* , y [de hecho lo hacen](https://queue.acm.org/detail.cfm?id=2655736) \[7]: en un incidente conocido [en GitHub](https://github.com/blog/1364-downtime-last-saturday) , los paquetes se retrasaron en la red durante aproximadamente 90 segundos \[8]. Esto significa que un proceso de aplicación puede enviar una solicitud de escritura y esta puede llegar al servidor de almacenamiento un minuto después, cuando el plazo de concesión ya ha expirado.
Incluso en redes bien gestionadas, este tipo de cosas pueden ocurrir. No se pueden hacer suposiciones sobre la sincronización, por lo que el código anterior es fundamentalmente inseguro, independientemente del servicio de bloqueo que se utilice.
### Cómo asegurar la cerradura con una valla
La solución a este problema es bastante sencilla: basta con incluir un *token de seguridad* en cada solicitud de escritura al servicio de almacenamiento. En este contexto, un token de seguridad es simplemente un número que aumenta (por ejemplo, incrementado por el servicio de bloqueo) cada vez que un cliente adquiere el bloqueo. Esto se ilustra en el siguiente diagrama:
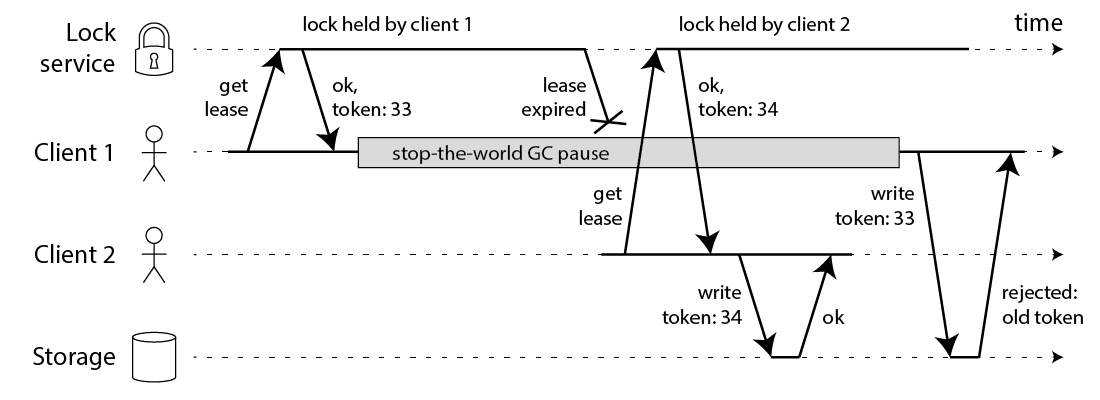 El cliente 1 adquiere el arrendamiento y obtiene un token de 33, pero luego entra en una pausa prolongada y el arrendamiento expira. El cliente 2 adquiere el arrendamiento, obtiene un token de 34 (el número siempre aumenta) y luego envía su escritura al servicio de almacenamiento, incluyendo el token de 34. Posteriormente, el cliente 1 vuelve a estar activo y envía su escritura al servicio de almacenamiento, incluyendo su token de 33. Sin embargo, el servidor de almacenamiento recuerda que ya procesó una escritura con un número de token mayor (34), por lo que rechaza la solicitud con el token 33.
Tenga en cuenta que esto requiere que el servidor de almacenamiento participe activamente en la verificación de tokens y rechace cualquier escritura en la que el token haya retrocedido. Pero esto no es particularmente difícil una vez que se conoce el truco. Y siempre que el servicio de bloqueo genere tokens estrictamente monótonamente crecientes, esto hace que el bloqueo sea seguro. Por ejemplo, si está utilizando ZooKeeper como servicio de bloqueo, puede usar el `zxid` número de versión de znode como token de seguridad y estará en buenas condiciones \[3].
Sin embargo, esto nos lleva al primer gran problema de Redlock: *no cuenta con ningún mecanismo para generar tokens de seguridad* . El algoritmo no produce ningún número que garantice un incremento cada vez que un cliente adquiere un bloqueo. Esto significa que, incluso si el algoritmo fuera perfecto en todos los demás aspectos, su uso no sería seguro, ya que no se puede evitar la condición de carrera entre clientes en caso de que uno de ellos se detenga o sus paquetes se retrasen.
Y no me resulta obvio cómo se podría modificar el algoritmo de Redlock para generar tokens de seguridad. El valor aleatorio único que utiliza no proporciona la monotonicidad necesaria. Simplemente mantener un contador en un nodo de Redis no sería suficiente, ya que ese nodo podría fallar. Mantener contadores en varios nodos provocaría que se desincronizaran. Es probable que se necesite un algoritmo de consenso solo para generar los tokens de seguridad. (Si tan solo [incrementar un contador](https://twitter.com/lindsey/status/575006945213485056) fuera sencillo).
### Utilizar el tiempo para resolver el consenso
El hecho de que Redlock no genere tokens de vallado ya debería ser razón suficiente para no usarlo en situaciones donde la corrección depende del bloqueo. Pero existen otros problemas que vale la pena analizar.
En la literatura académica, el modelo de sistema más práctico para este tipo de algoritmo es el [modelo asíncrono con detectores de fallos poco fiables](http://courses.csail.mit.edu/6.852/08/papers/CT96-JACM.pdf) \[9]. En otras palabras, los algoritmos no hacen suposiciones sobre la temporización: los procesos pueden pausarse durante periodos de tiempo arbitrarios, los paquetes pueden sufrir retrasos arbitrarios en la red y los relojes pueden estar desincronizados arbitrariamente; aun así, se espera que el algoritmo actúe correctamente. Teniendo en cuenta lo expuesto anteriormente, estas suposiciones son muy razonables.
El único propósito por el que los algoritmos pueden usar relojes es para generar tiempos de espera, para evitar esperas indefinidas si un nodo está caído. Pero los tiempos de espera no tienen por qué ser precisos: el hecho de que una solicitud expire no significa que el otro nodo esté definitivamente caído; podría deberse simplemente a una gran latencia en la red o a que el reloj local esté desincronizado. Cuando se usan como detector de fallos, los tiempos de espera son solo una suposición de que algo anda mal. (Si pudieran, los algoritmos distribuidos prescindirían por completo de los relojes, pero entonces [el consenso se volvería imposible](http://www.cs.princeton.edu/courses/archive/fall07/cos518/papers/flp.pdf) \[10]. Adquirir un bloqueo es como una operación de comparación y establecimiento, que [requiere consenso](https://cs.brown.edu/~mph/Herlihy91/p124-herlihy.pdf) \[11]).
Tenga en cuenta que Redis [utiliza`gettimeofday`](https://github.com/antirez/redis/blob/edd4d555df57dc84265fdfb4ef59a4678832f6da/src/server.c#L390-L404) un reloj , no un [reloj monótono](http://linux.die.net/man/2/clock_gettime) , para determinar la [expiración de las claves](https://github.com/antirez/redis/blob/f0b168e8944af41c4161249040f01ece227cfc0c/src/db.c#L933-L959) . La página de manual de `gettimeofday` [indica explícitamente](http://linux.die.net/man/2/gettimeofday) que la hora que devuelve está sujeta a saltos discontinuos en la hora del sistema; es decir, podría adelantarse repentinamente unos minutos o incluso retroceder en el tiempo (por ejemplo, si el reloj se [ajusta mediante NTP](https://www.eecis.udel.edu/~mills/ntp/html/clock.html) porque difiere demasiado de un servidor NTP, o si un administrador lo ajusta manualmente). Por lo tanto, si el reloj del sistema se comporta de forma anómala, podría ocurrir fácilmente que la expiración de una clave en Redis sea mucho más rápida o mucho más lenta de lo esperado.
Para los algoritmos en el modelo asíncrono, esto no representa un gran problema: estos algoritmos generalmente garantizan que sus propiedades *de seguridad se mantengan siempre,* [sin hacer suposiciones sobre la temporización](http://www.net.t-labs.tu-berlin.de/~petr/ADC-07/papers/DLS88.pdf) \[12]. Solo las propiedades *de vivacidad* dependen de tiempos de espera u otro detector de fallos. En otras palabras, esto significa que, incluso si la temporización del sistema es irregular (procesos en pausa, redes con retrasos, relojes que se adelantan y se atrasan), el rendimiento de un algoritmo podría verse gravemente afectado, pero el algoritmo nunca tomará una decisión incorrecta.
Sin embargo, Redlock no funciona así. Su seguridad depende de muchas suposiciones sobre la sincronización: asume que todos los nodos de Redis conservan las claves durante aproximadamente el tiempo correcto antes de que caduquen; que el retardo de la red es pequeño en comparación con la duración de la caducidad; y que las pausas del proceso son mucho más cortas que la duración de la caducidad.
### Romper el bloqueo de Redlock con tiempos inoportunos
Veamos algunos ejemplos para demostrar la dependencia de Redlock de las suposiciones de tiempo. Supongamos que el sistema tiene cinco nodos Redis (A, B, C, D y E) y dos clientes (1 y 2). ¿Qué sucede si el reloj de uno de los nodos Redis se adelanta?
1. El cliente 1 adquiere el bloqueo de los nodos A, B y C. Debido a un problema de red, no se puede acceder a los nodos D y E.
2. El reloj del nodo C se adelanta, lo que provoca que el bloqueo caduque.
3. El cliente 2 adquiere el bloqueo de los nodos C, D y E. Debido a un problema de red, no se puede acceder a A y B.
4. Los clientes 1 y 2 ahora creen que tienen el candado.
Un problema similar podría ocurrir si C falla antes de guardar el bloqueo en disco y se reinicia inmediatamente. Por este motivo, la documentación de Redlock [recomienda retrasar el reinicio](http://redis.io/topics/distlock#performance-crash-recovery-and-fsync) de los nodos que han fallado durante al menos el tiempo de vida del bloqueo de mayor duración. Sin embargo, este retraso en el reinicio depende de una medición del tiempo razonablemente precisa y fallaría si el reloj se desfasa.
Bien, tal vez pienses que un salto en el reloj es poco realista, porque confías plenamente en haber configurado correctamente NTP para que solo ajuste el reloj. En ese caso, veamos un ejemplo de cómo una pausa en un proceso puede provocar que el algoritmo falle:
1. El cliente 1 solicita el bloqueo de los nodos A, B, C, D y E.
2. Mientras se procesan las respuestas al cliente 1, este entra en un estado de GC que detiene todo el sistema.
3. Los bloqueos caducan en todos los nodos de Redis.
4. El cliente 2 adquiere el bloqueo en los nodos A, B, C, D, E.
5. El cliente 1 finaliza la recolección de basura y recibe las respuestas de los nodos Redis que indican que adquirió correctamente el bloqueo (estos se mantuvieron en los búferes de red del kernel del cliente 1 mientras el proceso estaba en pausa).
6. Los clientes 1 y 2 ahora creen que tienen el candado.
Cabe destacar que, si bien Redis está escrito en C y, por lo tanto, no cuenta con recolección de basura (GC), esto no nos sirve de ayuda en este caso: cualquier sistema en el que los *clientes* puedan experimentar una pausa de GC presenta este problema. La única forma de garantizar la seguridad es impedir que el cliente 1 realice operaciones bajo el bloqueo una vez que el cliente 2 lo haya adquirido, por ejemplo, mediante el método de aislamiento descrito anteriormente.
Un retardo prolongado en la red puede producir el mismo efecto que la pausa del proceso. Quizás dependa del tiempo de espera de usuario TCP: si lo configuras significativamente más corto que el TTL de Redis, es posible que los paquetes de red retardados se ignoren, pero tendríamos que analizar en detalle la implementación TCP para confirmarlo. Además, con el tiempo de espera, ¡volvemos a tener que considerar la precisión en la medición del tiempo!
### Los supuestos de sincronía de Redlock
Estos ejemplos demuestran que Redlock funciona correctamente solo si se asume un modelo de sistema *síncrono* , es decir, un sistema con las siguientes propiedades:
* retardo de red limitado (puedes garantizar que los paquetes siempre lleguen dentro de un retardo máximo garantizado),
* pausas de proceso limitadas (en otras palabras, restricciones estrictas de tiempo real, que normalmente solo se encuentran en sistemas de bolsas de aire para automóviles y similares), y
* Error de reloj limitado (cruza los dedos para que no obtengas la hora de un [servidor NTP defectuoso](http://xenia.media.mit.edu/~nelson/research/ntp-survey99/) ).
Cabe señalar que un modelo síncrono no implica relojes exactamente sincronizados: significa que se asume un [*límite superior fijo y conocido*](http://www.net.t-labs.tu-berlin.de/~petr/ADC-07/papers/DLS88.pdf) para el retardo de red, las pausas y la deriva del reloj \[12]. Redlock asume que los retardos, las pausas y la deriva son pequeños en relación con el tiempo de vida de un bloqueo; si los problemas de sincronización se vuelven tan grandes como el tiempo de vida, el algoritmo falla.
En un entorno de centro de datos con un comportamiento razonablemente bueno, las suposiciones de temporización se cumplirán *la mayor parte* del tiempo; esto se conoce como un [sistema parcialmente síncrono](http://www.net.t-labs.tu-berlin.de/~petr/ADC-07/papers/DLS88.pdf) \[12]. Pero, ¿es suficiente? Tan pronto como se incumplan esas suposiciones de temporización, Redlock puede violar sus propiedades de seguridad, por ejemplo, otorgando un arrendamiento a un cliente antes de que expire el de otro. Si la corrección de su bloqueo depende de ello, "la mayor parte del tiempo" no es suficiente; necesita que *siempre* sea correcto.
Hay abundante evidencia de que no es seguro asumir un modelo de sistema síncrono para la mayoría de los entornos de sistemas prácticos \[7,8]. Recuerda el incidente de GitHub con el [retraso de 90 segundos en los paquetes](https://github.com/blog/1364-downtime-last-saturday) . Es improbable que Redlock supere una prueba [de Jepsen](https://aphyr.com/tags/jepsen) .
Por otro lado, un algoritmo de consenso diseñado para un modelo de sistema parcialmente síncrono (o asíncrono con detector de fallos) tiene posibilidades de funcionar. Raft, Viewstamped Replication, Zab y Paxos entran en esta categoría. Dicho algoritmo debe prescindir de cualquier suposición sobre la temporización. Esto es difícil: resulta muy tentador suponer que las redes, los procesos y los relojes son más fiables de lo que realmente son. Pero en la compleja realidad de los sistemas distribuidos, hay que ser muy cuidadoso con las suposiciones.
### Conclusión
Creo que el algoritmo Redlock es una mala elección porque "no es ni una cosa ni la otra": es innecesariamente pesado y costoso para bloqueos de optimización de la eficiencia, pero no es lo suficientemente seguro para situaciones en las que la corrección depende del bloqueo.
En concreto, el algoritmo parte de suposiciones peligrosas sobre la sincronización y los relojes del sistema (básicamente asume un sistema síncrono con retardo de red y tiempo de ejecución de operaciones limitados), y viola las propiedades de seguridad si no se cumplen dichas suposiciones. Además, carece de un mecanismo para generar tokens de protección (que protegen al sistema contra retrasos prolongados en la red o en procesos en pausa).
Si solo necesitas bloqueos como medida de optimización de eficiencia (no por corrección), te recomiendo usar el [algoritmo de bloqueo de nodo único](http://redis.io/commands/set) para Redis (bloqueo condicional si no existe para obtener un bloqueo, eliminación atómica si el valor coincide para liberarlo) y documentar claramente en tu código que los bloqueos son aproximados y pueden fallar ocasionalmente. No te compliques configurando un clúster de cinco nodos Redis.
Por otro lado, si necesita bloqueos para garantizar la corrección, no utilice Redlock. En su lugar, utilice un sistema de consenso adecuado como [ZooKeeper](https://zookeeper.apache.org/) , probablemente mediante una de las [recetas de Curator](http://curator.apache.org/curator-recipes/index.html) que implementa un bloqueo. (Como mínimo, utilice una [base de datos con garantías transaccionales razonables](http://www.postgresql.org/) ). Además, exija el uso de tokens de seguridad en todos los accesos a recursos bajo el bloqueo.
Como dije al principio, Redis es una herramienta excelente si se usa correctamente. Nada de lo anterior disminuye su utilidad para los fines previstos. [Salvatore](http://antirez.com/) se ha dedicado al proyecto durante años, y su éxito es bien merecido. Pero toda herramienta tiene limitaciones, y es importante conocerlas y planificar en consecuencia.
Si desea obtener más información, explico este tema con mayor detalle en [los capítulos 8 y 9 de mi libro](http://dataintensive.net/) , disponible en versión preliminar de O'Reilly. (Los diagramas anteriores provienen de mi libro). Para aprender a usar ZooKeeper, recomiendo [el libro de Junqueira y Reed](http://shop.oreilly.com/product/0636920028901.do) \[3]. Para una buena introducción a la teoría de sistemas distribuidos, recomiendo [el libro de texto de Cachin, Guerraoui y Rodrigues](http://www.distributedprogramming.net/) \[13].
*Agradezco a* [*Kyle Kingsbury*](https://aphyr.com/) *,* [*Camille Fournier*](https://twitter.com/skamille) *,* [*Flavio Junqueira*](https://twitter.com/fpjunqueira) *y* [*Salvatore Sanfilippo*](http://antirez.com/) *por revisar un borrador de este artículo. Cualquier error es, por supuesto, mío.*
**Actualización 9 de febrero de 2016:** [Salvatore](http://antirez.com/) , el autor original de Redlock, ha [publicado una refutación](http://antirez.com/news/101) a este artículo (véase también [la discusión en HN](https://news.ycombinator.com/item?id=11065933) ). Presenta argumentos válidos, pero mantengo mis conclusiones. Si tengo tiempo, podría ampliar esta información en una publicación posterior, pero les pido que formen sus propias opiniones y consulten las referencias que aparecen a continuación, muchas de las cuales han sido sometidas a una rigurosa revisión académica por pares (a diferencia de nuestras publicaciones en el blog).