> For the complete documentation index, see [llms.txt](https://sorodriguezz.gitbook.io/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://sorodriguezz.gitbook.io/docs/system-design/fundamentos-de-bases-de-datos/database-architectures.md).
# Database Architectures
Determinar la mejor base de datos para una aplicación moderna que se implementará en múltiples centros de datos requiere una evaluación minuciosa que se adapte a diversos requisitos complejos de la aplicación. La base de datos se encargará de procesar lecturas y escrituras en múltiples geografías, replicar los cambios entre ellas y ofrecer las máximas garantías de disponibilidad, consistencia y durabilidad. Sin embargo, no todas las opciones tecnológicas son iguales. Por ejemplo, una tecnología de base de datos puede ofrecer una mayor garantía de disponibilidad, pero menores garantías de consistencia y durabilidad de los datos que otra. Las ventajas y desventajas de una tecnología de base de datos individual afectarán el comportamiento de la aplicación en la que se basa.
Lamentablemente, muchos arquitectos de aplicaciones tienen una comprensión limitada de las ventajas y desventajas específicas de las distintas bases de datos modernas. La creencia popular parece ser que, si una aplicación debe aceptar escrituras simultáneas en varios centros de datos, debe utilizar una base de datos multimaestro, donde varios maestros son responsables de una única copia o partición de los datos. Esta idea es errónea y se ve agravada por una comprensión limitada de las implicaciones (potencialmente negativas) que esta decisión tiene en el comportamiento de la aplicación.
Para aclarar este tema, esta publicación comenzará describiendo las capacidades de base de datos que requieren las aplicaciones modernas con múltiples centros de datos. A continuación, se describen las categorías de arquitecturas de base de datos utilizadas para satisfacer estos requisitos y se resumen las ventajas y desventajas de cada una. Finalmente, se analizará MongoDB específicamente y se describirá cómo encaja en estas categorías. Se enumerarán algunas de las capacidades específicas y opciones de diseño que ofrece MongoDB, lo que lo hace ideal para implementaciones de aplicaciones globales.
### Requisitos activo-activo
Cuando las organizaciones consideran implementar aplicaciones en múltiples centros de datos (o regiones de nube), suelen optar por una arquitectura activo-activo. En general, esto significa implementar una aplicación en múltiples centros de datos donde los servidores de aplicaciones de todos los centros de datos procesan solicitudes simultáneamente (Figura 1). Esta arquitectura busca lograr varios objetivos:
* Atender a una audiencia distribuida globalmente proporcionando procesamiento local (latencias bajas)
* Mantener la disponibilidad permanente, incluso ante cortes regionales completos
* Proporcionar la mejor utilización de los recursos de la plataforma al permitir que los recursos del servidor en múltiples centros de datos se utilicen en paralelo para procesar solicitudes de aplicaciones.
Una alternativa a una arquitectura activo-activo es una arquitectura de recuperación ante desastres activa (también conocida como activo-pasiva), que consta de un centro de datos principal (región) y una o más regiones de recuperación ante desastres (DR) (Figura 2). En condiciones normales de funcionamiento, el centro de datos principal procesa las solicitudes y el centro de DR permanece inactivo. El sitio de DR solo comienza a procesar las solicitudes (se activa) si falla el centro de datos principal. (En situaciones normales, los datos se replican del principal a los sitios de DR, de modo que estos últimos puedan tomar el control si falla el centro de datos principal).
La definición de arquitectura activa-activa no cuenta con un consenso universal. A menudo, también se utiliza para describir arquitecturas de aplicaciones similares a la arquitectura activa-DR descrita anteriormente, con la diferencia de que la conmutación por error del sitio principal al de DR es rápida (normalmente en unos segundos) y automática (sin intervención humana). En esta interpretación, una arquitectura activa-activa implica que el tiempo de inactividad de la aplicación es mínimo (prácticamente nulo).
Un error común es creer que una arquitectura de aplicación activa-activa requiere una base de datos multimaestro. Esto no solo es falso, sino que usar una base de datos multimaestro implica relajar requisitos que la mayoría de los propietarios de datos valoran: consistencia y durabilidad de los datos. La consistencia garantiza que las lecturas reflejen los resultados de las escrituras anteriores. La durabilidad de los datos garantiza que las escrituras confirmadas persistan permanentemente: no se pierden datos debido a la resolución de escrituras conflictivas o fallos de nodos. Ambos requisitos de la base de datos son esenciales para crear aplicaciones que se comporten de la forma predecible y determinista que los usuarios esperan.
Para abordar la idea errónea de los multimaestros, comencemos analizando las distintas arquitecturas de bases de datos que podrían usarse para lograr una aplicación activo-activo, así como sus ventajas y desventajas. Una vez hecho esto, profundizaremos en la arquitectura de MongoDB y veremos cómo se puede usar para implementar una arquitectura de aplicación activo-activo.
### Requisitos de base de datos para aplicaciones activas-activas
Al diseñar una arquitectura de aplicación activa-activa, el nivel de base de datos debe cumplir cuatro requisitos arquitectónicos (además de la funcionalidad de base de datos estándar: lenguaje de consulta potente con índices secundarios enriquecidos, acceso a datos de baja latencia, controladores nativos, herramientas operativas integrales, etc.):
1. Rendimiento: lecturas y escrituras de baja latencia. Esto suele implicar el procesamiento de lecturas y escrituras en nodos de un centro de datos local para la aplicación.
2. Durabilidad de los datos: se implementa replicando escrituras en múltiples nodos para que los datos persistan cuando ocurren fallas del sistema.
3. Coherencia: garantizar que los lectores vean los resultados de escrituras anteriores, que los lectores de varios nodos en diferentes regiones obtengan los mismos resultados, etc.
4. Disponibilidad: La base de datos debe seguir funcionando cuando fallan los nodos, centros de datos o conexiones de red. Además, la recuperación ante estos fallos debe ser lo más breve posible. Un requisito típico es de unos pocos segundos.
Debido a las leyes de la física, por ejemplo, la velocidad de la luz, no es posible que ninguna base de datos satisfaga completamente todos estos requisitos al mismo tiempo, por lo que la consideración importante para cualquier equipo de ingeniería que crea una aplicación es comprender las compensaciones que hace cada base de datos y seleccionar la que satisface los requisitos más críticos de la aplicación.
Veamos cada uno de estos requisitos con más detalle.
### Actuación
Por razones de rendimiento, es necesario que los servidores de aplicaciones en un centro de datos puedan realizar operaciones de lectura y escritura en los nodos de bases de datos del mismo centro, ya que la mayoría de las aplicaciones requieren tiempos de respuesta de milisegundos (de unos pocos a decenas) de las bases de datos. La comunicación entre nodos en múltiples centros de datos puede dificultar el cumplimiento de los acuerdos de nivel de servicio (SLA) de rendimiento. Si no es posible realizar operaciones de lectura y escritura locales, la latencia asociada al envío de consultas a servidores remotos afecta significativamente el tiempo de respuesta de las aplicaciones. Por ejemplo, los clientes en Australia no esperarían una experiencia de usuario mucho peor que la de los clientes en el este de EE. UU., donde se encuentra el centro de datos principal del proveedor de comercio electrónico. Además, la falta de ancho de banda de red entre los centros de datos también puede ser un factor limitante.
### Durabilidad de los datos
La replicación es una característica crucial en una base de datos distribuida. La base de datos debe garantizar que las escrituras realizadas en un nodo se repliquen en los demás nodos que mantienen réplicas del mismo registro, incluso si estos nodos se encuentran en ubicaciones físicas diferentes. La velocidad de replicación y las garantías de durabilidad de los datos varían según la base de datos y se ven influenciadas por:
* El conjunto de nodos que aceptan escrituras para un registro determinado
* Situaciones en las que puede producirse pérdida de datos
* Si se permiten escrituras conflictivas (dos escrituras diferentes que ocurren en el mismo registro en diferentes centros de datos aproximadamente al mismo tiempo) y cómo se resuelven cuando ocurren
### Consistencia
Las garantías de consistencia de una base de datos distribuida varían considerablemente. Esta variación depende de diversos factores, como si los índices se actualizan automáticamente con los datos, los mecanismos de replicación utilizados, la cantidad de información que cada nodo tiene sobre el estado de los registros correspondientes en otros nodos, etc.
El nivel de consistencia más bajo que ofrecen la mayoría de las bases de datos distribuidas es la consistencia eventual. Simplemente garantiza que, si se detienen todas las escrituras, el valor de un registro en todos los nodos de la base de datos finalmente se fusionará en el mismo valor. Ofrece pocas garantías sobre si un proceso de aplicación individual leerá los resultados de su escritura o si el valor leído es el último valor de un registro.
La mayor garantía de consistencia que pueden ofrecer las bases de datos distribuidas sin afectar gravemente el rendimiento es la consistencia causal. Según [Wikipedia](https://en.wikipedia.org/wiki/Causal_consistency#cite_note-7) , la consistencia causal ofrece las siguientes garantías:
* Leer sus escrituras: esto significa que las operaciones de escritura anteriores se indican y reflejan en las siguientes operaciones de lectura.
* Lecturas monótonas: esto implica que se garantiza que un conjunto creciente y actualizado de operaciones de escritura se indicará mediante operaciones de lectura posteriores.
* Las escrituras siguen a las lecturas: esto proporciona una garantía de que las operaciones de escritura siguen y vienen después de las lecturas por las cuales están influenciadas.
* Escrituras monótonas: esto garantiza que las operaciones de escritura deben realizarse después de otras escrituras que razonablemente deberían precederlas.
La mayoría de las bases de datos distribuidas ofrecen garantías de consistencia entre la consistencia eventual y la causal. Cuanto más cercana sea la consistencia causal, más se comportará una aplicación según las expectativas de los usuarios; por ejemplo, las consultas devolverán los valores de escrituras anteriores, no parecerá que se han perdido datos y los valores de los datos no cambiarán de forma no determinista.
### Disponibilidad
La disponibilidad de una base de datos describe su capacidad para sobrevivir a la pérdida de un nodo, un centro de datos o la comunicación de red. El grado en que la base de datos continúa procesando lecturas y escrituras ante diferentes tipos de fallos y el tiempo necesario para recuperarse determinarán su disponibilidad. Algunas arquitecturas permiten lecturas y escrituras en nodos aislados del resto del clúster de bases de datos por una partición de red, lo que proporciona un alto nivel de disponibilidad. Además, el tiempo que tarda la base de datos en detectar y recuperarse de fallos varía según la base de datos, y algunas requieren la intervención manual del operador para restablecer un clúster de bases de datos en buen estado.
### Arquitecturas de bases de datos distribuidas
Hay tres categorías amplias de arquitecturas de bases de datos implementadas para satisfacer estos requisitos:
1. Transacciones distribuidas mediante confirmación de dos fases
2. Multi-Master, a veces también llamado "sin maestro"
3. Base de datos particionada (fragmentada) con múltiples datos primarios, cada uno responsable de una partición única de los datos
Veamos cada una de estas opciones con más detalle, así como los pros y contras de cada una.
### Transacciones distribuidas con confirmación en dos fases
Un enfoque de transacción distribuida actualiza todos los nodos que contienen un registro como parte de una única transacción, en lugar de realizar escrituras en un nodo y luego replicarlas (asincrónicamente) en los demás. La transacción garantiza que todos los nodos recibirán la actualización; de lo contrario, la transacción fallará y todos los nodos volverán al estado anterior si se produce algún fallo.
Un protocolo común para implementar esta funcionalidad se denomina [confirmación en dos fases](https://en.wikipedia.org/wiki/Two-phase_commit_protocol) . Este protocolo garantiza la durabilidad y la consistencia entre múltiples nodos, pero sacrifica el rendimiento. Requiere dos fases de comunicación entre todos los nodos involucrados en la transacción, con solicitudes y confirmaciones enviadas en cada fase de la operación para garantizar que todos los nodos confirmen la misma escritura simultáneamente. Cuando los nodos de la base de datos se distribuyen en varios centros de datos, esto suele aumentar la latencia de las consultas de milisegundos a varios segundos. La mayoría de las aplicaciones, especialmente aquellas donde los clientes son usuarios (dispositivos móviles, navegadores web, aplicaciones cliente, etc.), consideran este tiempo de respuesta inaceptable.
### Multi-maestro
Una base de datos multimaestro es una base de datos distribuida que permite actualizar un registro en uno de los múltiples nodos agrupados posibles. (Las escrituras suelen replicarse, por lo que los registros existen en múltiples nodos y centros de datos). A primera vista, una base de datos multimaestro parece la plataforma ideal para implementar una arquitectura activa-activa. Permite que cada servidor de aplicaciones lea y escriba en una copia local de los datos sin restricciones. Sin embargo, presenta importantes limitaciones en cuanto a la consistencia de los datos.
El desafío radica en que dos (o más) copias del mismo registro pueden actualizarse simultáneamente en diferentes sesiones en distintas ubicaciones. Esto genera dos versiones distintas del mismo registro, y la base de datos, o en ocasiones la propia aplicación, debe resolver el conflicto para resolver esta inconsistencia. Generalmente, se utiliza una estrategia de resolución de conflictos, como la que prioriza la actualización más reciente o el registro con mayor número de modificaciones, ya que el rendimiento se vería significativamente afectado si se aplicara una estrategia de resolución más sofisticada. Esto también significa que los lectores en diferentes centros de datos pueden ver un valor diferente y conflictivo para el mismo registro durante el tiempo transcurrido entre la aplicación de las escrituras y la finalización del mecanismo de resolución de conflictos.
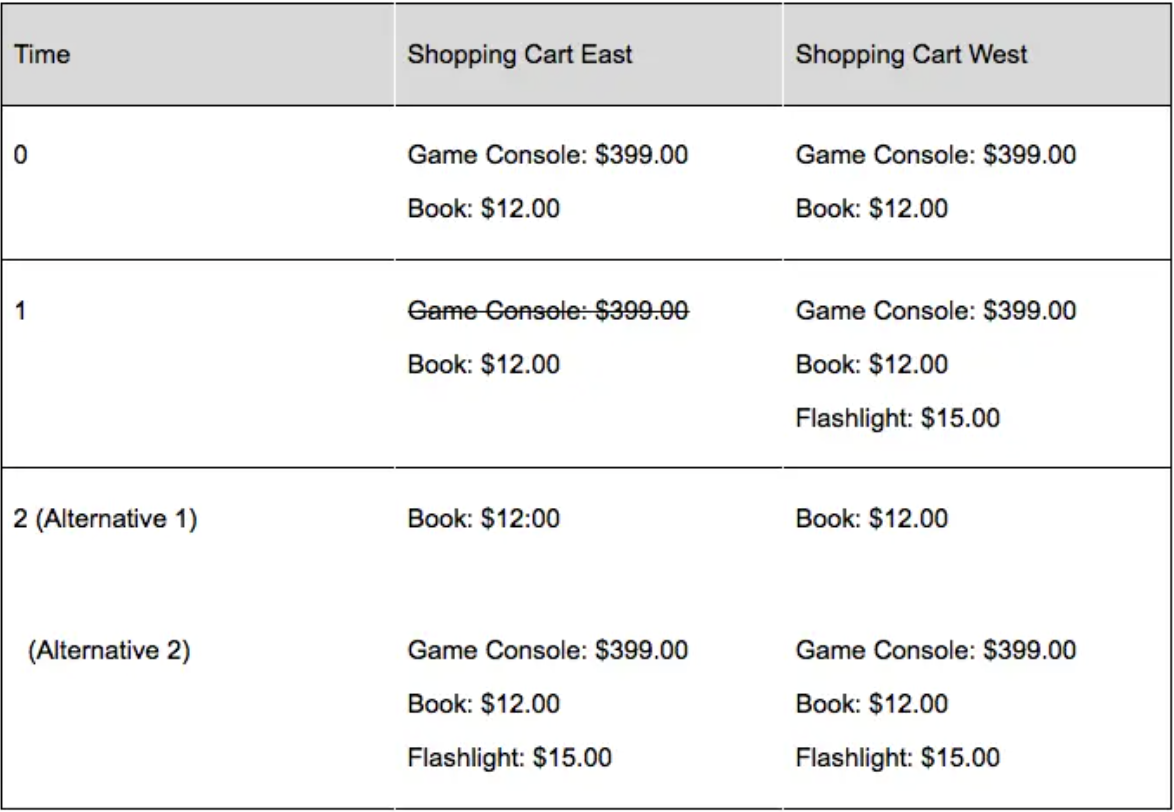
Por ejemplo, supongamos que utilizamos una base de datos multimaestro como almacén de persistencia para una aplicación de carrito de compras, la cual se implementa en dos centros de datos: Este y Oeste. Aproximadamente al mismo tiempo, un usuario en San Francisco añade un artículo a su carrito de compras (una linterna) mientras un proceso de gestión de inventario en el centro de datos Este invalida otro artículo del carrito de compras (una consola de videojuegos) para ese mismo usuario en respuesta a una notificación del proveedor sobre un retraso en la fecha de lanzamiento (véanse los tiempos 0 a 1 en la Figura 3).
En el momento 1, los registros del carrito de compra en los dos centros de datos son diferentes. La base de datos utilizará sus mecanismos de replicación y resolución de conflictos para resolver esta inconsistencia y, finalmente, se seleccionará una de las dos versiones del carrito (véase el momento 2 en la Figura 3). Utilizando la heurística de resolución de conflictos que suelen aplicar las bases de datos multimaestro (la última actualización prevalece o la más actualizada), es imposible para el usuario o la aplicación predecir qué versión se seleccionará. En cualquier caso, se pierden datos y se produce un comportamiento inesperado. Si se selecciona la versión Este, se pierde la selección de una linterna por parte del usuario; si se selecciona la versión Oeste, la consola de juegos sigue en el carrito. En cualquier caso, se pierde información. Finalmente, cualquier otro proceso que inspeccione el carrito de compra entre los momentos 1 y 2 también observará un comportamiento no determinista. Por ejemplo, un proceso en segundo plano que selecciona el almacén de cumplimiento y actualiza los costes de envío del carrito produciría resultados que entrarían en conflicto con el contenido final del carrito. Si el proceso se ejecuta en Occidente y la alternativa 1 se convierte en realidad, se calcularían los costos de envío para los tres artículos, aunque pronto el carrito podría tener solo un artículo: el libro.
El conjunto de casos de uso para bases de datos multimaestro se limita a la captura de datos no críticos, como los datos de registro, donde la pérdida ocasional de registros es aceptable. La mayoría de los casos de uso no toleran la combinación de pérdida de datos resultante de descartar una versión de un registro durante la resolución de conflictos y lecturas inconsistentes que ocurren durante este proceso.
### Base de datos particionada (fragmentada)
Una base de datos particionada la divide en particiones, llamadas fragmentos. Cada fragmento se implementa mediante un conjunto de servidores, cada uno de los cuales contiene una copia completa de los datos de la partición. La clave aquí es que cada fragmento mantiene el control exclusivo de su partición de datos. En cualquier momento, para cada fragmento, un servidor actúa como servidor principal y los demás como réplicas secundarias. Las lecturas y escrituras se realizan en la copia principal de los datos. Si el servidor principal falla por cualquier motivo (por ejemplo, un fallo de hardware o una partición de red), uno de los servidores secundarios se convierte automáticamente en el servidor principal.
Cada registro de la base de datos pertenece a una partición específica y es administrado por un único fragmento, lo que garantiza que solo se pueda escribir en el primario del fragmento. La asignación de registros a los fragmentos y la existencia de un único primario por fragmento garantizan la consistencia. Dado que el clúster contiene varios fragmentos y, por lo tanto, varios primarios (varios maestros), estos primarios pueden distribuirse entre los centros de datos para garantizar que las escrituras se realicen localmente en cada centro de datos (Figura 4).
Una base de datos fragmentada permite implementar una arquitectura de aplicaciones activa-activa implementando al menos tantos fragmentos como centros de datos y ubicando sus servidores primarios de forma que cada centro de datos tenga al menos un servidor primario (Figura 5). Además, los fragmentos se configuran de modo que cada uno tenga al menos una réplica (copia de los datos) en cada centro de datos. Por ejemplo, el diagrama de la Figura 5 muestra una arquitectura de base de datos distribuida en tres centros de datos: Nueva York (NYC), Londres (LON) y Sídney (SYD). El clúster tiene tres fragmentos, cada uno con tres réplicas.
* El fragmento de Nueva York tiene una primaria en Nueva York y secundarias en Londres y Sídney.
* El fragmento LON tiene una primaria en Londres y secundarias en Nueva York y Sídney.
* El fragmento SYD tiene una sede principal en Sídney y sedes secundarias en Nueva York y Londres.
De esta manera, cada centro de datos tiene servidores secundarios de todos los fragmentos para que los servidores de aplicaciones locales puedan leer todo el conjunto de datos y un servidor principal para un fragmento, de modo que las escrituras también se puedan realizar localmente.
La base de datos fragmentada cumple con la mayoría de los requisitos de consistencia y rendimiento para la mayoría de los casos de uso. El rendimiento es excelente porque las lecturas y escrituras se realizan en servidores locales. Al leer desde los servidores primarios, se garantiza la consistencia, ya que cada registro se asigna a un solo servidor primario. Esta opción requiere diseñar la aplicación para que los usuarios/consultas se dirijan al centro de datos que gestiona los datos (que contiene el servidor primario) para la consulta. Esto suele hacerse por geografía. Por ejemplo, si tenemos dos centros de datos en Estados Unidos (Nueva Jersey y Oregón), podríamos fragmentar el conjunto de datos por geografía (Este y Oeste) y dirigir el tráfico de los usuarios de la Costa Este al centro de datos de Nueva Jersey, que contiene el servidor primario para el servidor Este, y el de los usuarios de la Costa Oeste al centro de datos de Oregón, que contiene el servidor primario para el servidor Oeste.
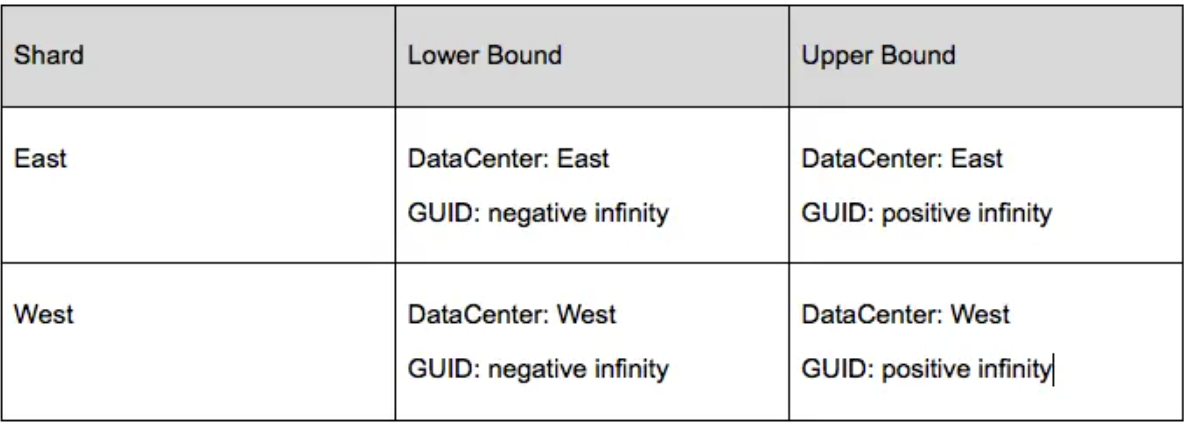
Repasemos el ejemplo del carrito de compra con una base de datos fragmentada. Supongamos, de nuevo, dos centros de datos: Este y Oeste. Para esta implementación, fragmentaríamos (particionaríamos) los carritos de compra según el ID de su tarjeta de compra, además de un campo de centro de datos que identifica el centro de datos donde se creó el carrito. La partición (Figura 6) garantizaría que todos los carritos con el valor "Este" en el campo DataCenter fueran gestionados por el fragmento con el principal en el centro de datos Este. El otro fragmento gestionaría los carritos con el valor "Oeste". Además, necesitaríamos dos instancias del servicio de gestión de inventario, una implementada en cada centro de datos, responsables de actualizar los carritos propiedad del centro de datos local.
Este diseño asume que existe un proceso externo que enruta el tráfico al centro de datos correcto. Al crear un nuevo carrito, la sesión del usuario se enruta al centro de datos geográficamente más cercano y se le asigna un valor de DataCenter. En el caso de un carrito existente, el enrutador puede usar el campo DataCenter del carrito para identificar el centro de datos correcto.
En este ejemplo, podemos ver que la base de datos fragmentada ofrece todas las ventajas de una base de datos multimaestro sin las complejidades derivadas de la inconsistencia de datos. Los servidores de aplicaciones pueden leer y escribir desde su servidor principal local, pero como cada cartucho pertenece a un único servidor principal, no se producen inconsistencias. Por el contrario, las soluciones multimaestro pueden provocar pérdida de datos y lecturas inconsistentes.
### Comparación de arquitecturas de bases de datos
Las ventajas y desventajas de la eficacia de cada arquitectura de base de datos para cumplir con los requisitos de las aplicaciones activas se muestran en la Figura 7. Al elegir entre bases de datos multimaestro y fragmentadas, la decisión se reduce a si la aplicación puede tolerar lecturas potencialmente inconsistentes y pérdida de datos. Si la respuesta es afirmativa, una base de datos multimaestro podría ser ligeramente más fácil de implementar. Si la respuesta es negativa, una base de datos fragmentada es la mejor opción. Dado que la inconsistencia y la pérdida de datos son inaceptables para la mayoría de las aplicaciones, una base de datos fragmentada suele ser la mejor opción.
### Aplicaciones activas-activas de MongoDB
MongoDB es un ejemplo de arquitectura de base de datos fragmentada. En MongoDB, la estructura de un servidor principal y un conjunto de servidores secundarios se denomina conjunto de réplicas. Los conjuntos de réplicas proporcionan alta disponibilidad para cada fragmento y se utiliza un mecanismo, denominado fragmentación de zonas, para configurar el conjunto de datos que gestiona cada fragmento. La fragmentación de zonas permite implementar la partición geográfica descrita en la sección anterior. Los detalles sobre cómo lograr esto se describen en el informe [técnico "Implementaciones de múltiples centros de datos de MongoDB"](https://www.mongodb.com/collateral/mongodb-multi-data-center-deployments) y en la [documentación sobre fragmentación de zonas](https://docs.mongodb.com/manual/tutorial/sharding-segmenting-data-by-location/) . Sin embargo, MongoDB funciona como se describe en la sección "Base de datos particionada (fragmentada)".
Numerosas organizaciones utilizan MongoDB para implementar arquitecturas de aplicaciones activas-activas. Por ejemplo:
* [Ebay](https://www.mongodb.com/blog/post/ebay-building-mission-critical-multi-data-center-applications-with-mongodb) ha codificado el uso de la fragmentación de zonas para permitir lecturas y escrituras locales como uno de sus patrones de arquitectura estándar.
* [YouGov](https://www.mongodb.com/blog/post/leaf-in-the-wild-yougov-powers-market-research-with-globally-distributed-mongodb) implementa MongoDB para su sistema de encuesta insignia, llamado Gryphon, en un patrón de "escritura local, lectura global" que facilita implementaciones de múltiples centros de datos activos-activos que abarcan centros de datos en América del Norte y Europa.
* [Ogilvy and Maher](https://www.mongodb.com/blog/post/ogilvy-and-mather-delivers-security-compliance-with-mongodb-enterprise-advanced) utiliza MongoDB como almacén de persistencia para su aplicación principal de auditoría. Su clúster fragmentado abarca tres centros de datos en Norteamérica y Europa, con centros de datos activos en Norteamérica y Europa continental, y un centro de datos de recuperación ante desastres en Londres. Esta arquitectura minimiza la latencia de escritura y también admite lecturas locales para análisis e informes centralizados de todo el conjunto de datos.
Además de la funcionalidad estándar de base de datos fragmentada, MongoDB ofrece controles precisos para la durabilidad de escritura y la consistencia de lectura, lo que lo hace ideal para implementaciones en múltiples centros de datos. Para las escrituras, se puede especificar una [preocupación de escritura](https://docs.mongodb.com/manual/reference/write-concern/) para controlar la durabilidad. Esta preocupación permite a la aplicación especificar el número de miembros del conjunto de réplicas que deben aplicar la escritura antes de que MongoDB la reconozca. Al proporcionar una preocupación de escritura, una aplicación puede estar segura de que, cuando MongoDB reconozca la escritura, los servidores de uno o más centros de datos remotos también la hayan aplicado. Esto garantiza que los cambios en la base de datos no se pierdan en caso de fallo de un nodo o del centro de datos.
Además, MongoDB aborda una de las posibles desventajas de una base de datos fragmentada: una disponibilidad de escritura inferior al 100 %. Dado que solo hay una base de datos principal para cada registro, si esta falla, existe un periodo en el que no se pueden realizar escrituras en la partición. MongoDB combina tiempos de conmutación por error extremadamente rápidos con escrituras reintentables. Con las escrituras reintentables, MongoDB proporciona soporte automatizado para reintentar escrituras que han fallado debido a errores transitorios del sistema, como fallos de red o elecciones de la base de datos principal, simplificando así significativamente el código de la aplicación.
La velocidad de la conmutación por error automatizada de MongoDB es otra característica distintiva que lo hace ideal para implementaciones con múltiples centros de datos. MongoDB puede conmutar por error en 2-5 segundos (dependiendo de la configuración y la confiabilidad de la red) cuando falla un nodo o centro de datos o se produce una división de la red. (Nota: las lecturas secundarias pueden continuar durante el período de conmutación por error). Tras un fallo, los miembros restantes del conjunto de réplicas elegirán un nuevo servidor principal y el controlador de MongoDB, sobre el que se basan la mayoría de las aplicaciones, lo identificará automáticamente. El proceso de recuperación es automático y las escrituras continúan tras finalizar la conmutación por error.
Para las lecturas, MongoDB ofrece dos funciones para especificar el nivel de consistencia deseado. En primer lugar, al leer desde nodos secundarios, una aplicación puede especificar un valor máximo de obsolescencia ( [maxStalenessSeconds](https://docs.mongodb.com/manual/core/read-preference/#maxstalenessseconds) ). Esto garantiza que el retardo de replicación del nodo secundario con respecto al nodo principal no pueda superar la duración especificada y, por lo tanto, garantiza la actualidad de los datos que devuelve el nodo secundario. Además, una lectura también puede asociarse con un [ReadConcern](https://docs.mongodb.com/master/reference/read-concern/index.html) para controlar la consistencia de los datos devueltos por la consulta. Por ejemplo, un ReadConcern de mayoria indica a MongoDB que solo devuelva datos replicados en la mayoría de los nodos del conjunto de réplicas. Esto garantiza que la consulta solo lea datos que no se perderán debido a un fallo en un nodo o centro de datos, y proporciona a la aplicación una visión consistente de los datos a lo largo del tiempo.
MongoDB 3.6 también introdujo [la consistencia causal](https://docs.mongodb.com/master/core/read-isolation-consistency-recency/#causal-consistency) , lo que garantiza que cada operación de lectura dentro de una sesión de cliente siempre verá la operación de escritura anterior, independientemente de la réplica que esté atendiendo la solicitud. Al imponer un orden causal estricto de las operaciones dentro de una sesión, la consistencia causal garantiza que cada lectura sea siempre lógicamente consistente, lo que permite lecturas monótonas desde un sistema distribuido, garantías que la mayoría de las bases de datos multinodo no pueden cumplir. La consistencia causal permite a los desarrolladores mantener las ventajas de la estricta consistencia de datos impuesta por las bases de datos relacionales de un solo nodo, a la vez que modernizan su infraestructura para aprovechar las ventajas de escalabilidad y disponibilidad de las plataformas de datos distribuidos modernas.
### Conclusión
En esta publicación, hemos demostrado que las bases de datos fragmentadas ofrecen el mejor soporte para los requisitos de replicación, rendimiento, consistencia y escritura y lectura locales de las aplicaciones activas. El rendimiento de las bases de datos de transacciones distribuidas es demasiado lento y las bases de datos multimaestro no ofrecen las garantías de consistencia necesarias. Además, MongoDB es especialmente adecuado para implementaciones en múltiples centros de datos gracias a su arquitectura distribuida, rápida conmutación por error y la capacidad de las aplicaciones para especificar las garantías de consistencia y durabilidad deseadas mediante las preocupaciones de lectura y escritura.